
Les tokens, c’est comme les jetons dans un casino, on en crame très vite et ça coûte cher ! Et là on se dit, mais pourquoi pas héberger en local ? En plus, on sera souverain.
Mais quelles ressources, combien de VRAM (mémoire vidéo / GPU), comment le calculer et le budgétiser ?
C’est très simple, rdv sur ce calculateur : https://apxml.com/tools/vram-calculator

On choisit sa catégorie : inférence / fine-tuning
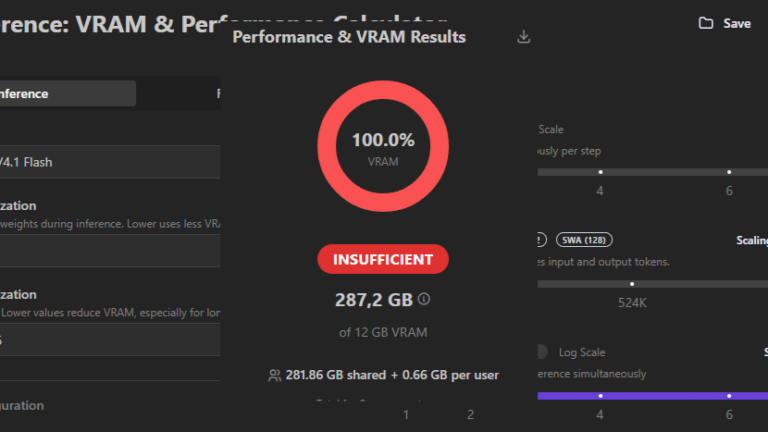
Son modèle, en l’occurence le dernier DeepSeek V4.1 Flash
La quantization, c’est à dire la compression du modèle. On réduit la précision du modèle pour gagner de la place. Généralement on choisit INT4 qui permet d’obtenir une excellente compression(~70%) tout en gardant une qualité acceptable.
Le KV Cache Quantization, c’est la compression du cache d’entrée. Pour chaque requête en entrée, on doit l’encoder et la stocker ce qui prend de la place.

Ensuite, on configure les variables d’exploitation de notre modèle, c’est à dire comment on va l’utiliser.
BatchSize : Le nombre de requête traité en même temps. Si on en a 32, notre modèle est capable de traiter 32 requêtes en même temps.
Sequence Length : La longeur en token de notre input + output. Plus elle est grande, plus cela nous prend du KV Cache. C’est important en fonction des requêtes prévues. Si on traite des gros documents, on aura besoin de grande séquence (> 32’000), si on traite des commentaires on aura besoin de moins (8’000 par exemple)
Et Concurrent Users : Le nombre d’utilisateur que nous prévoyons en même temps.

Et ensuite, voilà, nous avons la mémoire VRAM (Gpu) nécessaire pour faire tourner en local notre modèle en fonction de notre configuration.

On voit ici que la facture est salée. 282.7GB de VRAM.
J’aurai au minimum besoin de 6X NVidia Rtx 6000 Ada de 48 GB (~60’000$) ou d’un Mac Studio M3 Ultra avec 512 GB de mémoire unifiée (~15’000$).
Fait intéressant, on peut voir aussi la Generation Speed, le nombre de token par seconde généré, très important pour la rapidité de notre sytème.
On peut aussi faire une comparaison de coût avec du cloud. Si je louais cette même infrastructure en cloud, cela me reviendrai un peu près à $8.40 de l’heure. Soit 200$ par jour, 6000$ par mois, 72000$ par année. On peut voir alors que l’investissement dans un Mac Studio M3 Ultra (~15’000$) peut être amorti en moins de 3 mois.


 Français
 English